第一次训练模型,强化学习VS模仿学习
The question of whether a computer can think is no more interesting than the question of whether a submarine can swim. 讨论计算机会不会思考,就像讨论潜艇会不会游泳一样,没有多大意义。 from: Edsger Dijkstra
正文
近几日,笔者一直在学习AI相关的知识,也萌生了自己训练一个模型的想法,于是自己学着用pytorch实现了几个简单的模型。几个模型都是用来玩 flappy bird 这款经典游戏的。下面是几个模型的大致情况和我的经历及思考。
强化学习
| 版本 | 技术类别 | 训练次数 | 效果(平均成绩估计) |
|---|---|---|---|
| 1.0 | 强化学习 | 8000 | 0 |
| 1.1 | 强化学习 | 8000 | 2.1 |
| 1.2 | 强化学习 | 8000 | 0(模型崩了) |
模仿学习
| 版本 | 技术类别 | 训练次数 | 数据来源 | 效果(平均成绩) |
|---|---|---|---|---|
| 2.1 | 模仿学习 | 50 epochs | 规则专家+人工 | 37.5 |
| 2.1.1 | 模仿学习 | 50 epochs | 2.1 模型自采 | 47.0 |
| 2.1.2 | 模仿+强化 | 4000 集 | 2.1.1 数据预填充+在线DQN | 53.5 |
正文主体
环境搭建
先列一下环境,省得后来人踩同样的坑:
- Mac M 系列芯片(MPS GPU 加速)
- Python 3.13 + venv 虚拟环境
- PyTorch 2.14
- flappy-bird-gymnasium(OpenAI Gym 风格的 Flappy Bird 环境)
- pygame(渲染用)
第一个坑:VSCode 右上角 Run 按钮用的解释器,和你终端里 source activate 的虚拟环境,是两套东西。我一开始在终端装了 torch,点 Run 还是报 No module named 'torch',折腾半天才搞明白。
DQN 是什么(用我自己的话讲)
DQN 的核心就一句话:用神经网络预测”在这个局面下,每个动作未来大概能拿多少分”(Q值),然后选分数最高的动作。
就像打游戏的时候,你心里会盘算:”现在跳的话,大概能多飞 5 秒;不跳的话可能直接撞管子。”——神经网络干的就是这个盘算的活。
两个关键概念:
- 经验回放池:把玩过的每一帧都存起来,训练的时候随机抽一批。这样样本之间不相关,网络学得稳。
- 目标网络:不直接用正在训练的网络当”标准答案”,而是隔一段时间同步一次。不然就像自己给自己改作业,越改越偏。
版本迭代记录
v1.0:第一版 DQN,跑了个寂寞
配置:
- 网络:128 → 64 → 2 的 MLP
- 奖励:存活 +0.1,死亡 -1
- epsilon:从 1.0 开始衰减
结果:Reward 卡在 3.9,Score 永远是 0。小鸟根本不知道要穿管子。
踩的坑:我把 epsilon 衰减写在了 train_step() 里面——每跑一步(每一帧)就衰减一次。一局游戏有几百帧,跑两局 epsilon 直接从 1.0 掉到 0.01,模型还没开始探索就不探索了。
这个 bug 卡了我很久。当时还纳闷为什么 epsilon 开局就是 0.01,明明设的是 1.0。后来才反应过来:衰减放错位置了,应该在每一局结束才衰减一次,而不是每一帧。
v1.1:大奖励尺度,学会了穿管子但不稳
改动:
- 修复 epsilon 衰减位置(每集衰减一次)
- 穿管子奖励改成 +100,死亡 -10
- 存活每帧 +0.01,前 4000 集跳跃不扣分
结果:终于会穿管子了!跑 10 局测试,平均 2.1 分,最高 4 分。
但问题很多:
- 模型是”碰巧”穿过管子的,不是真的学会了
- Reward 在 -9.5 上下波动,说明小鸟每次还是活 50 帧左右就死
- 所有 checkpoint 文件大小一模一样(129373 字节),说明从第 1000 集开始权重就没怎么变过——模型收敛了,但收敛到了一个很差的局部最优
为什么会这样? 前 2000 集纯随机探索,到第 2494 集才碰巧穿过第一次管子。这时候 epsilon 已经开始降了,模型只见过一次”穿管子”的样本,根本没学会怎么复现这个动作,epsilon 就降到 0.05 了。
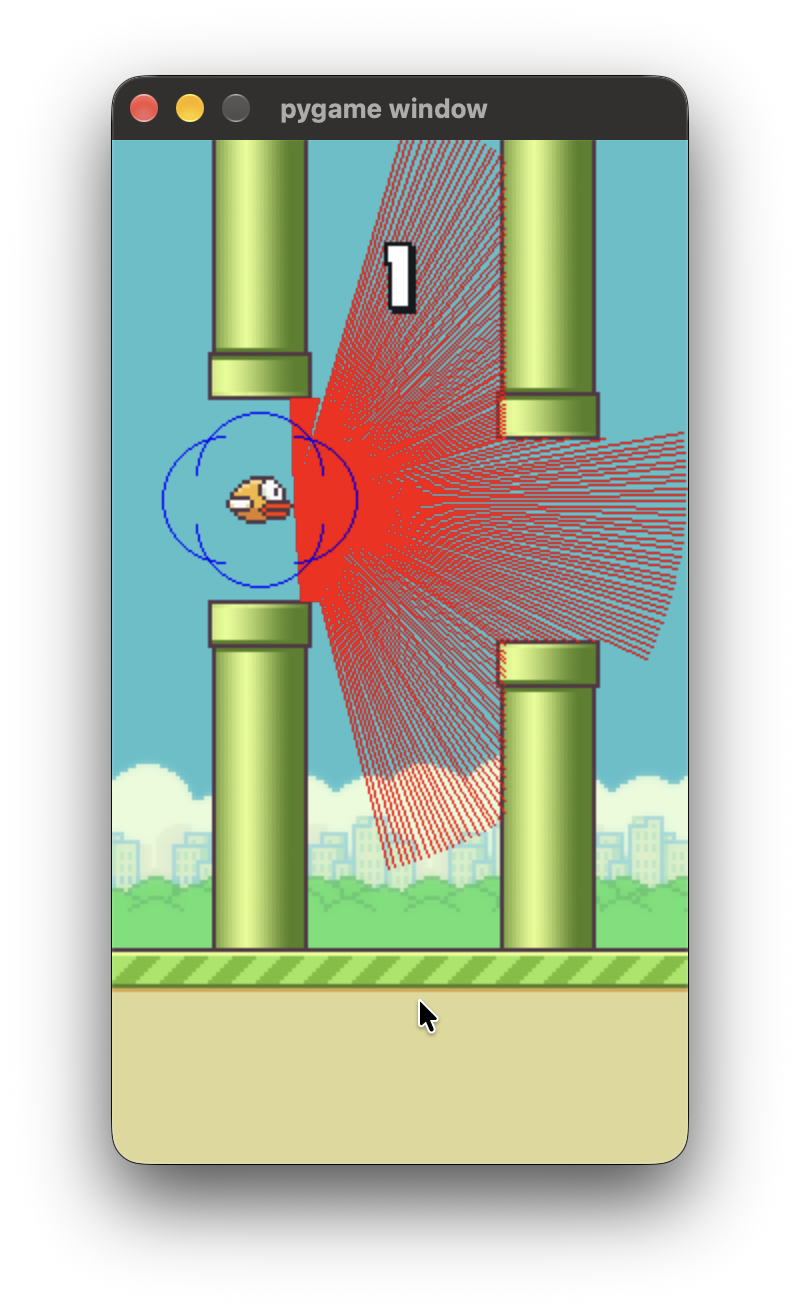
v1.2:自适应 epsilon,结果模型直接”躺平”
改动:
- 奖励尺度缩小:死亡 -1,存活 +0.1,穿管子 +1
- 第一次穿管子额外 +10(发现奖),之后每次 +1
- epsilon 改成自适应:只要最近 100 集平均 Score < 0.5,就保持 1.0 纯随机探索;等学会了才开始降
思路:v1.1 的问题是”还没学会就停止探索了”。那就反过来——什么时候学会了,什么时候再停止探索。听起来很合理对吧?
结果:前 2300 集一直 Score=0,epsilon 因为平均 Score 不够,就一直保持 1.0,纯随机瞎跑。好不容易在 2300 集左右穿过第一次管子,模型开始学了——但学歪了。
最终崩了:模型学会的策略是一直跳。小鸟一开局就疯狂扇翅膀,直直飞到屏幕顶部,然后卡死在天花板附近。Score 还是 0,因为根本到不了管子那里。
为什么会这样? 这是个新的局部最优陷阱:
- 一直跳 → 至少能活几十帧 → 每帧 +0.1,总比随机乱飞死得快强
- 模型一算:跳!无脑跳!反正活着就有钱拿
- 至于穿管子?太远了,先活着再说
奖励函数只给了”活着”和”穿管子”两个信号,但没有告诉模型”不能无脑一直跳”。模型就挑了个最省力的活法:一直往上飞。
这和 v1.1 的”破罐子破摔”是同一个问题的两面:奖励梯度不够密,模型总能找到一条偷懒的路。
视频效果:
几个印象很深的概念
1. epsilon 到底是什么
epsilon 就是”随机瞎试的概率”。1.0 就是完全瞎玩,0.01 就是基本靠脑子。
前期要高(多试错),后期要低(多利用)。但降太快就会”还没学会就毕业了”,降太慢就一直不收敛。这个节奏的把控,比网络结构还重要。
2. 奖励函数是指南针
这是这次最大的体会。奖励设计比网络结构重要 10 倍。
- 第一版没有穿管子奖励,模型就不知道”穿管子”是好事,只能学到”别死”
- 第二版 +100 太猛,Q 值一会儿 +100 一会儿 -10,神经网络根本学不稳
- 第三版改成小而持续的奖励,才算是正常人能学的难度
奖励信号不清晰,模型再努力也找不到方向——就像蒙着眼爬山,连哪边是山顶都不知道。
3. “破罐子破摔”是真的
死亡惩罚一开始设了 -100,模型直接摆烂:反正穿管子也赚不回来一次死亡的分,干脆不学了。心理学里叫什么效应我忘了,但和人考试考砸了之后破罐破摔一模一样。
4. 探索 vs 利用
这是强化学习最核心的矛盾:
- 探索:随机试新动作,可能发现更好的策略,但也可能撞墙
- 利用:按已知的最优策略来,稳定但可能错过更好的
怎么平衡?纯手动调 epsilon 曲线是最笨的办法,自适应 epsilon(根据当前表现动态调整)才是正道。
模仿学习
模仿学习是啥?就是抄作业。
强化学习是自己摸索:AI 啥都不知道,只能在游戏里瞎试,撞死一万次才知道”哦,原来管子不能碰”。问题是游戏给的反馈太抠门了,大部分时间只告诉你”你死了”,至于怎么不死,全靠自己悟。
模仿学习就简单粗暴:找个会玩的当老师,把老师怎么玩的录下来,AI 照着学。就像你学一个新游戏,不是从认识手柄开始,而是先看大佬操作,然后模仿,再慢慢形成自己的手感。
行为克隆,三步走
行为克隆(Behavior Cloning)是模仿学习里最朴素的一种,就三步:
- 录轨迹:让专家玩,每一帧记录”当前状态 → 专家做了什么操作”
- 训练分类器:让神经网络学会”看到这个状态 → 输出那个动作”。本质就是个分类问题
- 推理:模型自己玩,每帧预测动作,一路操作下去
说白了,就是把”怎么打游戏”的问题,转化成”给状态打标签”的问题。这是我竞赛老本行啊,跟 OI 里背板子似的,先把标准解法学会,再谈别的。
v2.1:纯模仿,37.5 分
我搞了个规则专家(其实就是个”往管道缺口中心飞”的伺服器)玩了一百局,又手动录了点,凑了 58,682 帧轨迹。网络结构 12→128→64→2,训练 50 轮,分类准确率 99.26%。
测试平均 37.5 分。什么概念?我手动玩也就十来分(游戏水平确实烂)。AI 学一晚上比我练一天强,有点被打击到,但方向对了。
v2.1.1:让模型自己教自己,47 分
瓶颈在数据。规则专家虽然稳,但动作太机械,多样性不够。我寻思:让 v2.1 模型自己玩、自己录数据,再用这数据训练 v2.1.1——相当于”学成的师兄来教新师弟”。
这里踩了个大坑:一开始我给采集加了一点随机探索(5% 概率乱动),结果平均每局只有 0.9 分!因为 Flappy Bird 的伺服是精确节奏,任何一次乱跳都会直接撞死。专家数据必须纯 deterministic,一点噪声都不能有。改成纯 argmax 后录了 300 局、177,889 帧,训练 acc 99.50%,测试平均 47 分,直接涨了 25%。
v2.1.2:模仿+强化,一路崩到怀疑人生,最后 53.5 分
模仿学得这么好,自然想接上强化学习”再上一层楼”(上面 DQN 的仇还没报)。结果噩梦开始了:
- 直接把模仿模型权重当 DQN 起点?崩,eval 直接归零
- 加专家数据预填充、加模仿辅助损失?崩
- 冻结特征层只练输出层?崩
- 换 PPO?还是崩,一放开策略就崩
前前后后试了七八种组合,全崩。查了一圈资料才明白:模仿模型的输出是分类 logits(小数),DQN 要的是 Q 值(大数),同一个输出层不可能同时满足两种语义——就像一个人不可能同时当好判卷老师和考生,分工压根不一样。
这个坑其实前文就有伏笔:DQN 学的是”这个动作未来大概值多少分”(Q 值),模仿学的是”这个状态下该按哪个键”(分类)。两套世界观,硬塞进同一个输出层,谁都不服谁。
最后换成学术圈标准的 DQfD 数据级方案:Q 网络从零学,但把专家的 17.8 万帧轨迹全部预填充进经验池,再配合修复了探索率死锁的 DQN(前文 v1.2 那个”自适应 epsilon 卡死”的坑,这轮又踩了一遍才彻底修对)。训练后期又踩到 DQN 自举误差累积、长局崩坏的坑,最后靠 early stopping(挑训练中期的 checkpoint)拿到了 53.5 分。
为什么模仿学习这么猛?
一句话:抄作业永远比自己摸索快。
强化学习的奖励太稀疏了:Flappy Bird 只有”穿管 +1”和”死亡 -1”,中间几千帧动作全凭自己猜。而模仿学习每一步都有标准答案(专家在这一帧就是跳了/没跳),信号密度完全不同——一个是每帧有答案的作业题,一个是只告诉你期末成绩的开卷考。
但也要承认:纯模仿的上限就是老师的水平,我这模型顶多学到”规则专家 + 我自己”的程度。想超过老师,就得靠强化学习。可模仿+强化这条路,我是真真切切撞了一晚上墙,最后靠数据级 DQfD 才勉强走通。
踩坑清单
- 动作分布极度不平衡:300 局 17.8 万帧,跳跃率只有 5.4%——95% 的帧都是”不跳”。模型要是学会”永远不跳”,准确率也有 94.6%,但它完全不会玩。所以分类准确率 99.5% 这种数字别太当真,要看实际游戏分数
- 数据里不能有噪声:5% 随机探索就让平均分从 40+ 掉到 0.9,教训极其深刻
- eval 会骗人:训练中期的短 eval 全程满分,一测长局就现原形,后期 DQN 崩坏全靠长局测试才抓出来
- 模仿和强化的”世界观”不同:logits 和 Q 值尺度不匹配,直接搬权重必崩
思考
作为 OI 出身的人,最大的感受是:AI 学习和打竞赛很像,先学套路再创新。模仿学习就是”背套路”,强化学习是”自己发明套路”。背套路永远是最快的入门方式,但天花板有限;自己发明套路难,但上限高。而”背了套路再创新”(模仿+强化)——理论很美好,实践全是坑,但这也正是最有意思的地方。
这条路还很长,但方向已经清楚了。
总结
这趟从”强化学习撞墙”到”模仿学习开挂”的完整旅程,收获比想象中大得多。最终成绩单:RL 折腾三个版本最好才 2.1 分,模仿学习一步到位 37.5 分,自采数据二次训练 47 分,最后模仿+强化做到 53.5 分。回头看,最值钱的不是分数,而是这几个认知:
强化学习难的不是写代码,是设计奖励和调探索节奏。奖励梯度不够密,模型总能找到偷懒的路(无脑跳、躺平等死);epsilon 降太早”没学会就毕业”,降太晚一直不收敛——这两个坑占了 RL 踩坑的大头。
模仿学习本质上是数据工程。网络就三层 MLP,真正拉开差距的是数据:规则专家+人工只有 37.5 分,换成模型自采的 17.8 万帧优质轨迹直接 47 分。而且专家数据一点噪声都不能有,5% 的随机探索就能把平均分从 40+ 打到 0.9。
“先模仿后强化”的正确姿势是 DQfD 数据级。直接拿模仿模型权重初始化 Q 网络必崩(分类 logits 和 Q 值是两套世界观),试了七八种组合全崩后才学乖:Q 网络从零学、专家数据预填充经验池,再配合在线 DQN。另外 DQN 后期自举误差累积会崩,early stopping 是保命技。
评价口径要统一,短 eval 会骗人。训练中 600 帧 eval 全程满分,3000 帧长局测试才发现后期崩坏——模型选型一定要用和最终目标一致的测试。
先学套路再创新,是打竞赛也是学 AI 的正路。模仿 = 背套路,强化 = 自己发明套路。背套路上手最快,但上限是老师;自己摸索上限高,但代价是撞墙。最好的路径是”背了套路再创新”——难,但值得。
三个版本做到 53.5 分只是开始。下一步打算试试让模型直接看画面(CNN 端到端),或者用 Double DQN 治一治后期崩坏。等有新进展再来更新这篇 🐦
写于 2026.09.21,MacBook Pro 前,从 RL 的 2.1 分一路折腾到 53.5 分的深夜。
这篇文章是笔者先写+AI润色的模式,这是我写过最长的文章了,还是学术类的,大概写了3小时左右。
笔者水平较低,文章仅描述实际情况,欢迎邮件交流。
朱柘名
2026.9.21
于华南理工大学